Quando vi o lançamento do Qwen 3.8 27B, eu tive uma reação bem direta. Finalmente um modelo aberto, com visão, licença Apache 2 e tamanho que faz sentido para uso local sério. Ele vem do laboratório de pesquisa Qwen, ligado à Alibaba, e chega com 27 bilhões de parâmetros em uma faixa muito atraente para quem gosta de rodar IA no próprio hardware.
O primeiro impacto do Qwen 3.8 27B é simples: ele promete muito para um modelo que ainda cabe na rotina de quem tem uma máquina forte em casa.
O entusiasmo inicial não veio só da ficha técnica. Os benchmarks divulgados também chamaram atenção. Pelos números apresentados, ele supera o Qwen 3.6 27B e o Qwen 3.7-Plus, que até maio deste ano eram referências bem fortes dentro da própria família. Para quem trabalha com código, imagem e automação, isso acende uma luz imediata. Eu pensei no mesmo instante em fluxos de AI-Building como os que a Replitfy defende: menos fricção entre ideia, arquitetura e entrega funcional.
Mas benchmark sozinho não fecha questão. Eu quis ver o comportamento real. O que ele faz quando sai do gráfico e entra no laptop? Como ele reage em tarefas simples, em tarefas visuais e em loops de agente? E, principalmente, como lida com o raciocínio profundo que vem ativado por padrão?
O ambiente dos testes
Eu rodei o modelo em dois cenários bem diferentes, mas ambos capazes:
MacBook Pro M5 Max com 128 GB de memória.
NVIDIA DGX Spark.
Versão quantizada de 17 GB carregada no LM Studio.
Tentativas extras com o llama-server para comparar comportamento e margem de ajuste.
Na prática, a versão quantizada de 17 GB é o que torna o Qwen 3.8 27B tão chamativo para uso local.
No LM Studio, a experiência de carga foi tranquila. O modelo abriu, respondeu e já mostrou um dos seus traços mais marcantes: ele pensa demais. Em alguns casos, muito além do que eu queria. Isso não é um defeito puro e simples. É uma escolha de configuração. Pela documentação, o padrão de “razão extra alta”, ou xhigh, vem ativado por padrão. A proposta é levar o modelo a um raciocínio muito profundo. Em tese, isso ajuda em tarefas mais difíceis. Na prática, ele pode exagerar.
Quando o xhigh passa do ponto
Foi aí que os testes ficaram realmente interessantes. Em perguntas normais, eu percebi que o modelo começava a gastar contexto demais. A janela padrão de 8.192 tokens era lotada com facilidade. Em vez de chegar logo ao que foi pedido, ele abria trilhas internas extensas, refinava plano, revia detalhes e seguia ampliando a resposta antes mesmo de responder de fato.
O modo xhigh faz o Qwen 3.8 27B raciocinar com profundidade real, mas também aumenta o risco de exagero e desperdício de contexto.
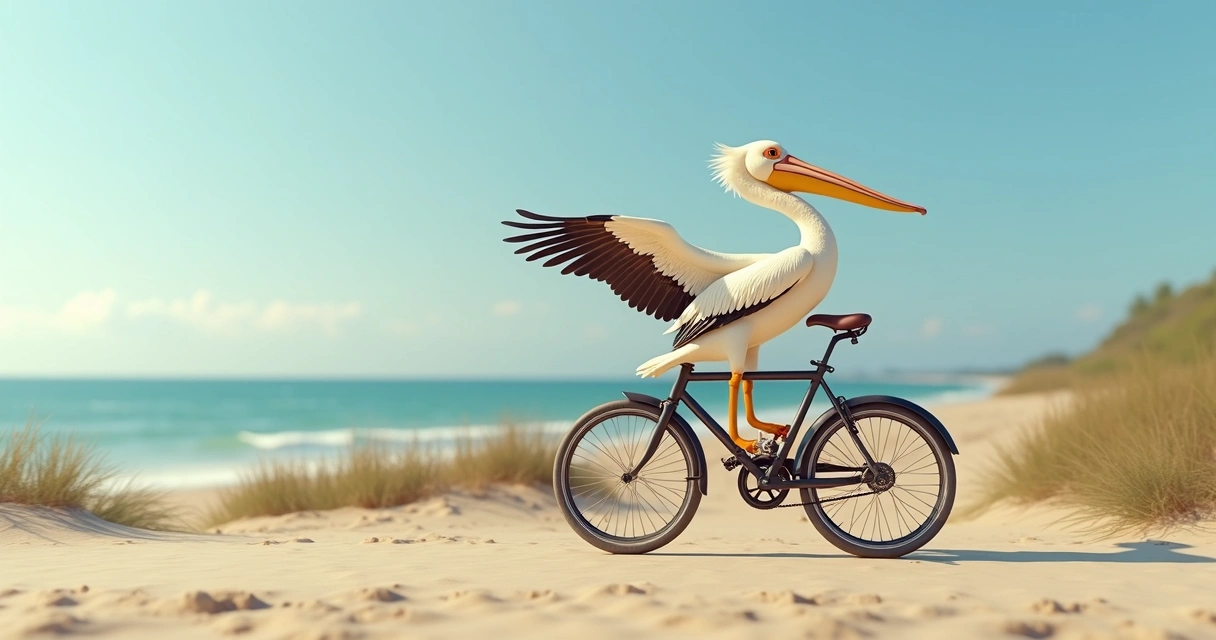
Para contornar isso, eu liberei a capacidade máxima de 262.144 tokens. A mudança resolve o estrangulamento imediato do contexto. Só que traz outro custo: o tempo. E esse tempo não é pequeno. Em um dos testes mais ilustrativos, eu pedi um SVG de um pelicano pedalando uma bicicleta. A resposta saiu depois de 21 minutos, com 22.276 tokens de raciocínio e 3.223 tokens na saída final.
Pensou demais. Entregou tarde.
O mais curioso é que o resultado visual foi bom. Muito bom, na verdade. A anatomia da bicicleta estava correta. A anatomia do pelicano também. Havia senso de composição, elementos de movimento no fundo e um desenho que parecia feito por alguém tentando agradar além do pedido. O arquivo tinha personalidade. Não era uma saída mecânica.
Mesmo assim, eu saí com uma sensação dupla. Admiração técnica, sim. Satisfação prática, nem tanto. O tempo investido foi desproporcional ao ganho final.
O mesmo prompt sem raciocínio
Eu então repeti o mesmo prompt com o raciocínio desativado. A diferença foi clara. O modelo respondeu em cerca de 2 minutos e, curiosamente, gerou mais tokens na saída. Foi um caso em que pensar menos ajudou a entregar mais rápido e de modo mais direto. O arquivo final perdeu parte da sofisticação interna do raciocínio profundo, mas continuou bom o bastante para uso real.
Sem raciocínio ativado, o Qwen 3.8 27B ficou mais ágil e ainda manteve uma qualidade útil para tarefas criativas.
Eu também comparei essa ideia com o resultado obtido ao enviar o mesmo tipo de pedido para o modelo maior Qwen 3.8 2.4T-A95B. O contraste que senti foi menos sobre capacidade bruta e mais sobre custo de espera. O modelo maior mostrou uma leitura mais estável do pedido, com menos tropeços de intenção, mas o 27B local continuou impressionando pelo simples fato de existir nesse tamanho e entregar algo visualmente convincente fora de infraestrutura pesada.
Para quem acompanha o movimento de AI-Building e trabalha com ciclos curtos de prototipação, como a comunidade da Replitfy costuma fazer, isso é um sinal forte. Nem sempre eu preciso da maior máquina possível. Às vezes, eu preciso de uma boa máquina perto de mim, sob meu controle, respondendo offline.
O teste do círculo mostrou muito
Depois eu fiz um teste quase banal: pedi para desenhar um círculo em SVG. Só isso. Um círculo. E foi aí que o comportamento do xhigh apareceu de forma quase didática.
Em vez de um círculo simples, o modelo sugeriu animações, paletas mais ricas, acabamento visual, sombras, composição adicional e outros elementos que não faziam parte do pedido. O resultado ficou bonito. Mas não era o que eu tinha pedido.
O teste do círculo mostra que o xhigh tende a transformar uma tarefa simples em um projeto criativo maior do que o necessário.
Eu gosto de modelos que tentam ir além. Porém existe uma linha fina entre iniciativa e desvio. Nesse caso, o Qwen 3.8 27B mostrou que pode ser brilhante em interpretação ampla, mas ainda precisa de contenção quando a tarefa pede precisão seca.
Isso me lembrou uma lição que eu vejo com frequência em formação técnica: nem toda boa resposta é uma boa entrega. Em processos de construção com IA, tema que aparece bastante em conteúdos da categoria de AI-Building, saber enquadrar o modelo é tão valioso quanto saber escrever o prompt.
Visão, bounding boxes e iniciativa demais
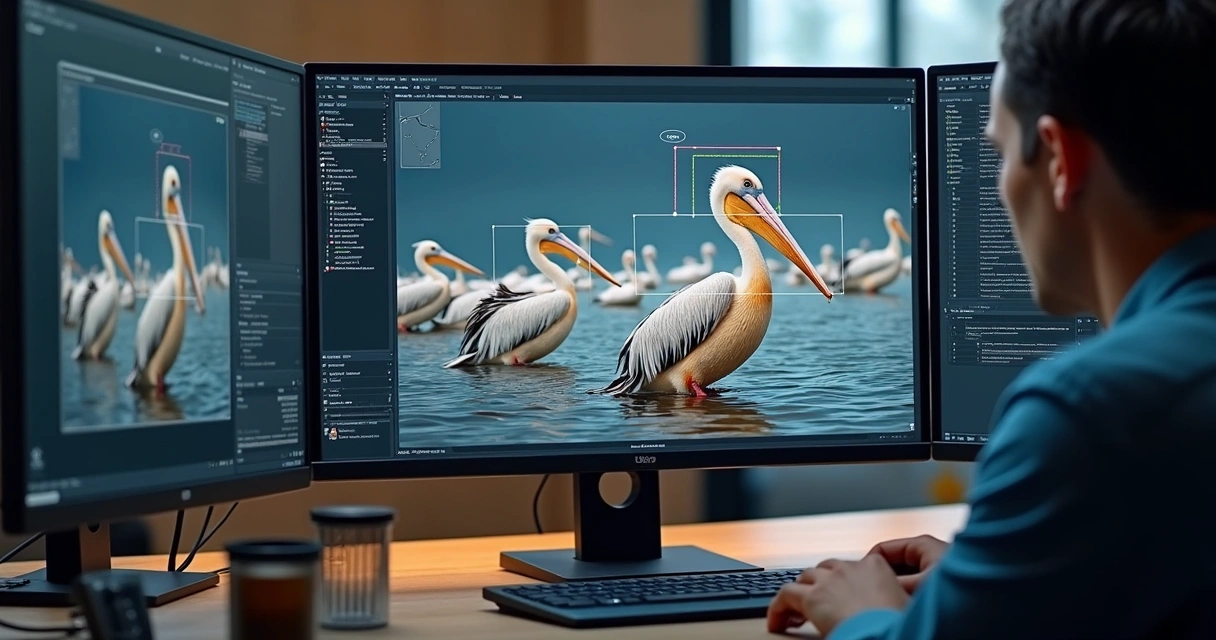
Na parte de visão, eu testei anotação de bounding boxes em imagens de pelicanos. Aqui o modelo me interessava por dois motivos. Primeiro, pela precisão visual. Segundo, pela capacidade de transformar uma solicitação em ferramenta de trabalho.
Os resultados foram bons. As caixas vieram com precisão convincente, e o raciocínio detalhado ajudou a entender como o modelo estava localizando os objetos. Mais do que isso, ele foi capaz de construir uma ferramenta completa de visualização das caixas praticamente a partir de um único comando.
O Qwen 3.8 27B mostrou boa leitura visual e conseguiu montar uma interface de visualização útil sem que eu pedisse cada etapa.
O lado curioso apareceu de novo. Ele acrescentou coisas que eu não solicitei, como uma cena demo para exibir as anotações. Pelas thinking traces, dava para perceber a lógica: ele parecia interpretar a tarefa não só como “gere coordenadas”, mas como “entregue uma solução apresentável”. Isso pode ser ótimo em alguns contextos e irritante em outros.
Quando desliguei o modo de raciocínio e repeti a tarefa, o resultado não saiu correto de primeira. Isso me chamou atenção. Em tarefas de visão com maior exigência lógica, o raciocínio profundo parece de fato ajudar. O custo é o aumento do tempo de resposta. Mas, neste caso, eu senti que havia ganho real de qualidade.
Como ele se saiu como agente de código
Eu também quis ver o Qwen 3.8 27B fora do campo de geração isolada. Coloquei o modelo em uso com o Pi Agent, em ciclos de geração e chamada de ferramentas. Esse teste me agradou mais do que eu esperava.
Ele respondeu dúvidas sobre autenticação de forma satisfatória. Depois foi além: escreveu um script em Python para converter transcripts em JSONL para Markdown, gerou o código, executou testes e ajustou o comportamento de forma autônoma dentro do loop disponível.
Como agente de código, o Qwen 3.8 27B já mostra maturidade suficiente para tarefas reais com geração, teste e ajuste de scripts.
Essa parte é especialmente relevante para quem está estudando novas formas de desenvolvimento assistido por IA. Na Replitfy, a ideia de co-criar com IA dentro de fluxos de construção completos aparece o tempo todo. E aqui eu vi um exemplo concreto disso: um modelo local, relativamente compacto, conseguindo participar de um ciclo de trabalho útil, sem depender o tempo inteiro de serviço remoto.
Para quem gosta de aprender por prática, vale acompanhar também conteúdos ligados a novidades do Replit e a aplicações reais como este guia sobre como aplicar AI-Building em projetos reais usando Replit. Esse contexto ajuda a entender por que um modelo assim chama tanta atenção.
Desempenho: bom, mas ainda lento
Agora vem a parte menos agradável. O modelo passa uma sensação constante de lentidão. Nas minhas execuções, a faixa de velocidade girou entre 15 e 30 tokens por segundo. Não é inútil. Dá para trabalhar. Mas ainda está longe daquela fluidez que faz a pessoa esquecer que está esperando.
A maior barreira prática do Qwen 3.8 27B hoje não é capacidade, e sim velocidade.
Essa limitação pesa mais quando o raciocínio profundo entra em cena. Se o modelo decide gastar milhares de tokens internos antes de responder, qualquer tarefa simples começa a parecer longa demais. Por isso, eu não vejo ainda uma troca total, no meu uso diário, para experiências hospedadas mais velozes. O local ganha em controle, privacidade e autonomia. Mas perde em ritmo.
Parte disso parece vir do gargalo de largura de banda de memória. Outra parte vem do fato de ele não usar uma arquitetura Mixture-of-Experts, o que reduziria o custo por token em certos cenários. O resultado é um modelo muito capaz para o tamanho, porém ainda pesado no fluxo contínuo.
As tentativas para acelerar
Nem tudo ficou parado nesse ponto. A comunidade já começou a testar formas de acelerar o modelo. Um dos caminhos mais comentados foi o Multi-Token Prediction, ou MTP, que já vem embutido. Seguindo dicas compartilhadas por Georgi Gerganov no ecossistema do llama.cpp, houve benchmark no Spark com ganho de 72%.
O uso de Multi-Token Prediction mostrou que ainda existe espaço real para acelerar bastante o Qwen 3.8 27B em execução local.
Esse dado me deixou animado. Não porque ele apague o problema de velocidade agora, mas porque indica margem clara de melhora. Em modelos locais, isso faz muita diferença. Às vezes o modelo não precisa mudar. O stack em volta amadurece, os runtimes melhoram, os parâmetros de execução ficam mais afinados e a experiência dá um salto.
Eu vejo algo parecido acontecer com frequência no aprendizado acelerado. Um bom modelo não vive só do treinamento original. Ele vive do ecossistema que cresce em volta dele. É um ponto que combina muito com o que eu já discuti ao falar de vibe coding e aceleração do aprendizado em 2026.
O que eu concluí depois dos testes
Depois de rodar o Qwen 3.8 27B no MacBook Pro M5 Max com 128 GB e no NVIDIA DGX Spark, eu fiquei com uma conclusão bem clara. Ele é um avanço real. Não porque seja perfeito. Não é. Mas porque entrega um conjunto muito raro para um modelo local de 17 GB: contexto longo, visão, chamada de ferramentas, boa geração de código e raciocínio profundo quando a tarefa pede mais lógica.
Rodar localmente um modelo de 17 GB com esse nível de capacidade já é, por si só, um salto enorme em relação ao que era viável há um ano.
Hoje eu consigo imaginar vários usos concretos com ele:
Geração de código com revisão iterativa.
Anotação de imagens com bounding boxes.
Automação offline em ambientes sensíveis.
Prototipação visual em SVG.
Agentes com ferramentas em loops curtos.
Ao mesmo tempo, eu não ignoraria seus limites. O padrão xhigh precisa de cuidado. Em tarefas simples, ele tende a exagerar. A velocidade ainda incomoda. E o custo de esperar raciocínios muito extensos reduz parte do brilho da experiência.
Mesmo assim, o saldo é positivo. O Qwen 3.8 27B aponta para um futuro em que modelos abertos ficam mais acessíveis, mais capazes e mais próximos da rotina de quem constrói software. Se esse tema faz sentido para você, eu sugiro acompanhar o trabalho de Roberto de Jesus Oliveira e conhecer melhor a Replitfy, onde esse tipo de prática se conecta com formação técnica, AI-Building e criação de produtos reais com IA.
Perguntas frequentes
O que é o Qwen 3.8 27B?
O Qwen 3.8 27B é um modelo de linguagem com 27 bilhões de parâmetros, com suporte a visão e licença Apache 2. Ele foi lançado pela Qwen, laboratório de pesquisa ligado à Alibaba. Na prática, ele chama atenção por combinar tamanho relativamente compacto, contexto longo, geração de código, leitura de imagens e uso local em máquinas fortes.
Como instalar o Qwen 3.8 27B localmente?
Pelo que eu testei, o caminho mais simples é usar uma versão quantizada do modelo em uma ferramenta de execução local, como o LM Studio, ou então configurar um servidor local compatível, como o llama-server. Depois, basta ajustar memória, janela de contexto e parâmetros de raciocínio. Se o modo xhigh vier ativado, eu recomendo testar também com raciocínio reduzido ou desligado para tarefas simples.
Vale a pena usar o Qwen 3.8 27B?
Sim, vale a pena se você quer um modelo local forte para código, visão, automação e uso offline. Eu diria que ele vale mais ainda para quem aceita trocar parte da velocidade por controle, privacidade e flexibilidade. Se o seu foco é resposta imediata em qualquer tarefa, a lentidão ainda pode atrapalhar.
Quais são os requisitos para rodar Qwen 3.8 27B?
Para uma experiência boa, eu vejo vantagem clara em hardware robusto, como um notebook topo de linha com muita memória unificada ou uma máquina com GPU forte. Nos meus testes, o modelo rodou em um MacBook Pro M5 Max com 128 GB e em um NVIDIA DGX Spark. A versão quantizada de 17 GB ajuda bastante, mas contexto alto e raciocínio profundo ainda pedem bastante da máquina.
Qwen 3.8 27B é melhor que outros modelos?
Eu prefiro responder de forma objetiva: ele é muito bom dentro da proposta dele. Pelos dados divulgados no lançamento, ele supera versões anteriores fortes da própria linha, e nos meus testes mostrou avanços reais em visão, código e raciocínio local. Ainda assim, “melhor” depende do uso. Se a prioridade for rodar localmente com bom alcance técnico, ele entra com muita força nessa conversa.