Eu gosto de observar o momento em que uma ideia simples vira software jogável. Quando isso acontece com apoio de IA, o processo fica ainda mais revelador. Foi assim neste experimento com o Codex Desktop rodando GPT-5.6 Sol Ultra, em um modo com uso intenso de subagentes, para criar um jogo a partir de uma proposta já testada antes em outros contextos.
O resultado foi um game jogável, com identidade própria, feito em 52 minutos e marcado por uma falha visual tão estranha quanto instrutiva.
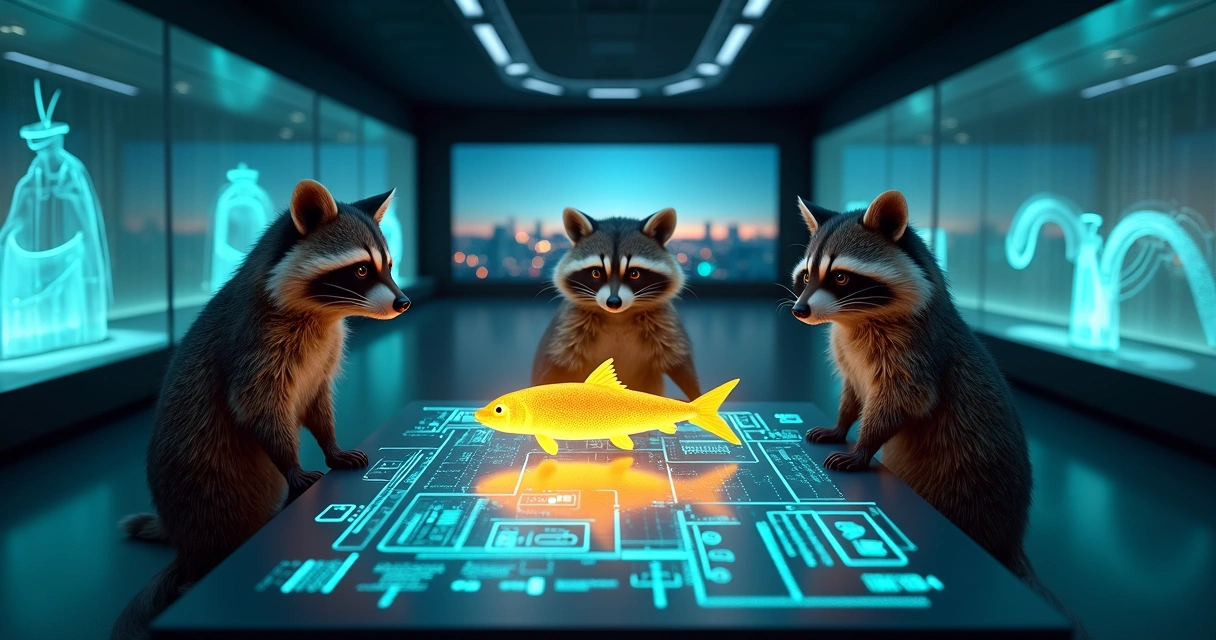
O ponto de partida já tinha história. Anos antes, no GPT-3, a ideia de “Raccoon Heist” mostrava uma equipe de guaxinins ladrões fazendo assaltos ousados a bancos e roubando arte valiosa. Depois, em Fable, a mesma semente virou outra coisa: o jogador controlava um único guaxinim recolhendo moedas e peixes no quintal. Era simpático, funcional, mas menos fiel ao tema de assalto.
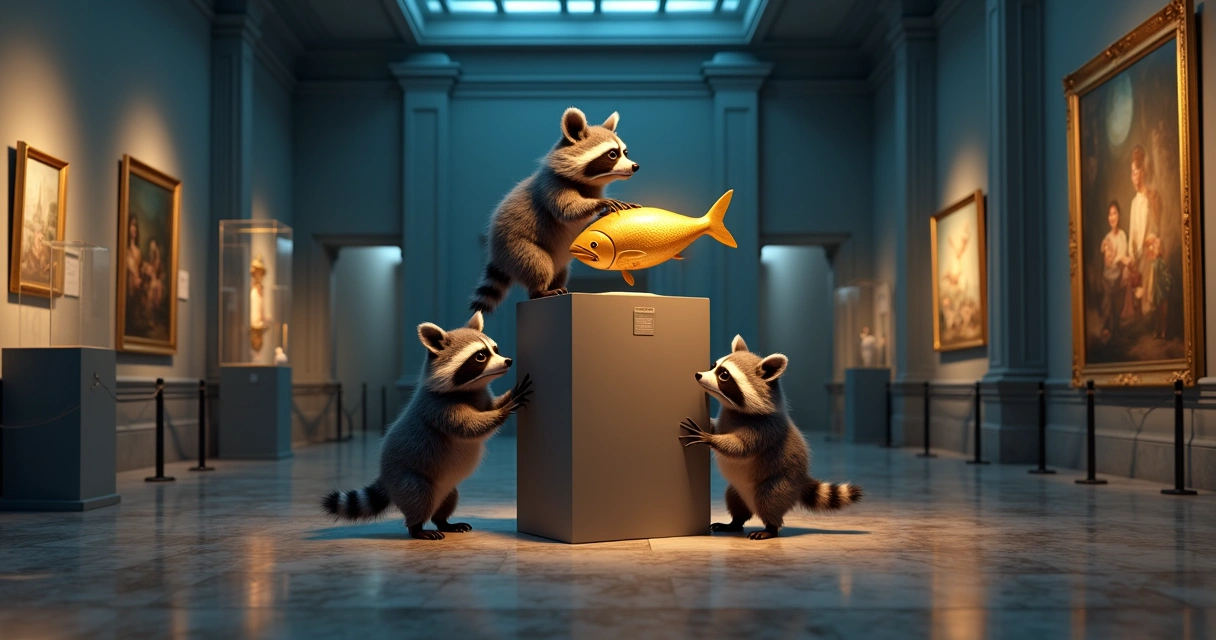
Nesta nova rodada, o GPT-5.6 Sol Ultra recebeu a mesma linha criativa, só que entregou uma solução mais coesa. O cenário passou a ser um museu. O jogador precisava resgatar os outros dois guaxinins da equipe para empilhá-los e, juntos, alcançar e roubar uma sardinha dourada. Eu achei esse detalhe ótimo. É engraçado, claro, mas também cria uma meta visual fácil de entender e uma mecânica central simples de aprender.
Esse tipo de raciocínio interessa muito a quem acompanha a Replitfy, porque mostra na prática como AI-Building não é só pedir código. É pensar objetivo, fluxo, ativos, revisão, correção e entrega final no mesmo ciclo.
De onde veio a proposta
Antes de falar do experimento em si, eu acho útil situar a linhagem da ideia. O conceito original de “Raccoon Heist” nasceu como uma fantasia de crime cartunesco. Havia equipe, plano, roubo e ambição. Depois, um texto anterior mostrou como Claude Fable 5 construiu um game funcional em apenas um prompt, baseado numa ideia gerada com GPT-3 e DALL-E quatro anos antes. Essa versão ficou melhor e mais fiel ao tema de “heist”. O repositório do Moonlight & Mayhem foi disponibilizado no GitHub, com texturas e prompts criados pelo gpt-image-2, além de um link para jogar esse game.
Esse histórico permitiu comparar não só qualidade de código, mas também fidelidade criativa à proposta original.
Na prática, eu não estava olhando apenas para “quem programa melhor”. Eu queria ver quem entende melhor a intenção do jogo. E intenção, em game design, pesa muito. Um jogo pode funcionar tecnicamente e ainda assim perder o centro da ideia.
Foi aí que o GPT-5.6 Sol Ultra me chamou atenção. Em vez de reduzir a proposta a uma coleta genérica, ele preservou o espírito de equipe e de infiltração, mesmo em uma escala menor e mais viável para um experimento rápido.
Como o experimento foi conduzido
Eu acompanhei o processo no Codex Desktop, usando o modo com uso intenso de subagentes. Isso muda bastante a natureza do trabalho. Em vez de uma resposta única e linear, o sistema distribui tarefas, revisa partes do projeto, gera artefatos, ajusta lógica e segue refinando o resultado.
O experimento levou 52 minutos do começo ao fim. Esse tempo, para mim, já diz muita coisa. Não foi uma simples geração instantânea. Foi um ciclo real de criação com idas e vindas, revisão visual e correção depois de teste.
Para quem quer entender esse tipo de fluxo de trabalho, eu sugiro acompanhar a categoria de AI-Building, porque esse caso se encaixa bem na ideia de construir junto com a IA, e não apenas receber uma resposta pronta.
Durante a execução, o Codex produziu e revisou partes do jogo. O repositório final incluiu toda a transcrição do processo. Isso ajuda muito quem quer estudar o caminho de criação, os impasses e os ajustes. Há, porém, uma limitação prática: não existe ali o recurso de “copiar como Markdown” presente no Claude Code. Pode parecer detalhe, mas para quem documenta, ensina ou reaproveita prompts, esse tipo de ausência pesa no dia a dia.
Ter a transcrição completa do processo ajuda a transformar um experimento isolado em material de estudo reutilizável.
O game que surgiu
O jogo gerado pelo GPT-5.6 Sol Ultra adotou um cenário de museu, o que eu considero uma decisão muito boa. Um museu já carrega vigilância, obstáculo, objeto raro e atmosfera de roubo. Não foi preciso explicar muito para o jogador entender o contexto.
O objetivo era claro:
Entrar no museu;
Encontrar os outros dois guaxinins;
Resgatá-los;
Empilhá-los para ganhar altura;
Alcançar a sardinha dourada.
Eu gosto dessa estrutura porque ela cria progressão sem ficar complexa demais. Primeiro há busca. Depois, composição da equipe. Por fim, execução do roubo. O jogo conta uma pequena história por mecânica, não só por texto.
Roubar sozinho não bastava.
Essa ideia de empilhar os guaxinins deu ao projeto um toque próprio. Não era apenas um item final distante. Era preciso reunir a equipe para tornar o roubo possível. Em termos de design, isso aproxima mecânica e narrativa.
O melhor acerto do conceito foi transformar cooperação em condição física para completar o roubo.
Esse tipo de solução conversa bem com a proposta da Replitfy de formar gente capaz de pensar sistemas ponta a ponta. O código importa, claro. Mas o que diferencia um projeto memorável é quando a lógica do software conversa com o motivo do software existir.
Onde os subagentes fizeram diferença
Quando eu penso em subagentes, penso em divisão de trabalho. Não no sentido corporativo, mas no sentido cognitivo. Um agente cuida da lógica. Outro avalia ativos. Outro revisa saída. Outro testa. No modo intenso, essa separação tende a aparecer com mais força.
No caso deste game, isso ajudou em pelo menos três frentes:
Na transformação do conceito em mecânica jogável;
Na organização dos elementos de cena e objetivos;
Na geração e revisão de imagens durante o processo.
Mas aqui apareceu uma lição muito humana. Mesmo com várias camadas de revisão, o sistema deixou passar um defeito visual absurdo.
O detalhe estranho que passou despercebido
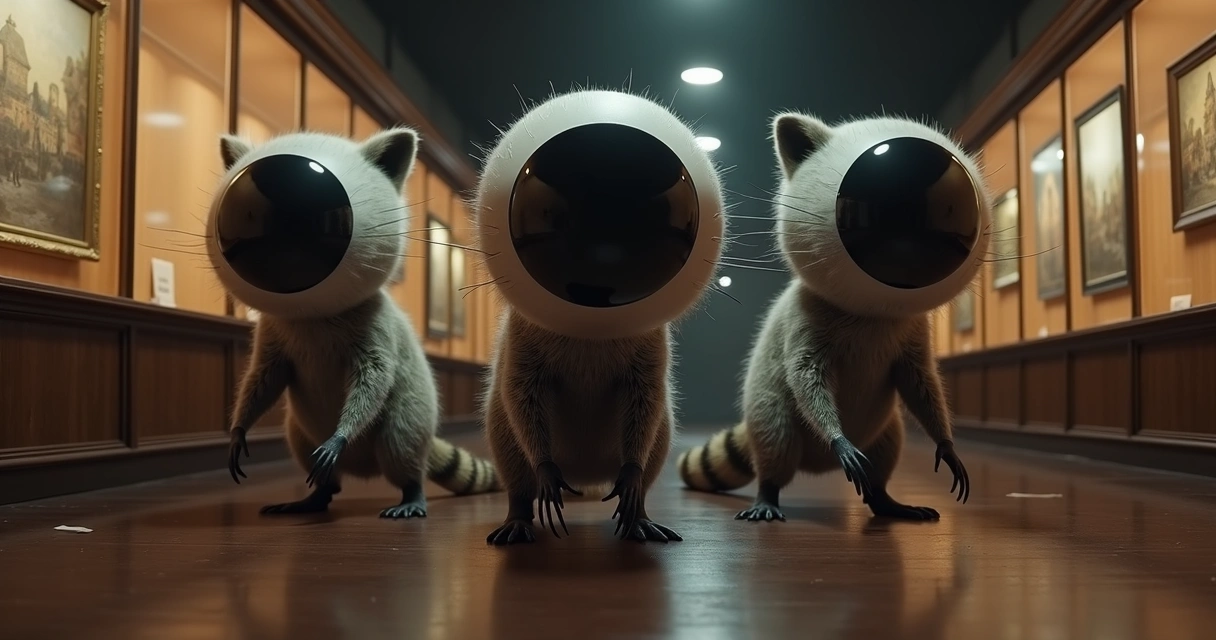
Na versão gerada a partir de um prompt único, cada guaxinim surgiu com um olho enorme. Não era um olho exagerado de desenho animado comum. Era como uma esfera preta gigante pairando sobre a cabeça. Quando eu li essa descrição do resultado, precisei parar e rir por um momento. Era bizarro. E justamente por isso, memorável.
A falha visual mais marcante do experimento não foi de código, mas de percepção durante a revisão automática.
O mais curioso é que o Codex revisou as imagens durante a criação e não detectou o problema. Só percebeu depois que o defeito foi apontado diretamente com outra pergunta no prompt. A correção veio logo em seguida. Ou seja, havia capacidade de corrigir, mas faltou sensibilidade inicial para notar o erro.
Esse episódio ensina algo simples e forte. Revisão automática ajuda. Revisão humana ainda decide muito. Em AI-Building, eu vejo isso o tempo todo: a IA consegue produzir, verificar e iterar, mas a direção de qualidade ainda melhora muito quando alguém sabe o que perguntar.
Para quem está aplicando esse método em projetos reais com Replit, vale ler este conteúdo sobre como aplicar AI-Building em projetos reais usando Replit, porque a parte de revisão orientada por objetivo aparece o tempo inteiro.
O que esse erro revela
Eu vejo dois aprendizados claros aqui. O primeiro é técnico. Verificação visual automatizada ainda pode falhar até em problemas gritantes, sobretudo quando o sistema está mais ocupado em validar consistência geral do que estranhezas semânticas finas.
O segundo é metodológico. Uma boa pergunta muda a qualidade da entrega. Ao questionar diretamente o defeito, a correção apareceu rápido. Isso mostra que o gargalo não era incapacidade total, mas foco.
Em fluxos com IA, a pergunta de revisão pode ser tão valiosa quanto o prompt inicial.
Na Replitfy, eu vejo esse ponto como parte da maturidade em vibe coding. Não basta acelerar. É preciso saber inspecionar o que foi criado. Aliás, para quem quer acompanhar esse lado mais prático, faz sentido ver também a categoria de novidades do Replit, já que muitos avanços de ambiente mudam a forma como esses experimentos ganham escala.
Custos, tempo e documentação
O tempo registrado foi de 52 minutos. Isso por si só já posiciona bem o esforço. Não foi um projeto longo, mas também não foi trivial. Houve criação, revisão, bug visual, nova pergunta e ajuste.
Também foi mencionada uma estimativa de custo pelo AgentsView caso o pagamento tivesse sido feito pelas taxas normais de API, e não pela assinatura mensal. O valor, porém, não foi especificado. Ainda assim, esse dado parcial já serve para lembrar que workflows com subagentes podem ter um preço de bastidor maior do que parece quando vistos só pelo resultado final.
Eu gosto quando experimentos trazem esse tipo de transparência. Tempo, custo estimado, transcrição e repositório deixam de ser curiosidade e viram material didático.
Se o leitor estiver começando e quiser uma visão mais ampla do impacto desse modo de criar, recomendo este texto sobre vibe coding para acelerar aprendizado em 2026. Ele ajuda a ligar experimentos como este a uma rotina real de formação.
O que eu achei do resultado final
Eu achei o jogo melhor do que uma simples prova de conceito. Ele não apenas executou uma tarefa. Ele reinterpretou uma proposta antiga com mais unidade. O museu, o resgate dos parceiros e o roubo da sardinha dourada formaram um conjunto que faz sentido do começo ao fim.
Claro, houve tropeço. O episódio do olho gigante entra quase como símbolo disso. A IA pode acertar a estrutura geral e ainda falhar de forma muito estranha em um detalhe básico. Mesmo assim, o mais interessante foi ver a correção acontecer logo após uma pergunta objetiva.
O experimento mostra que subagentes ampliam o alcance da criação, mas não dispensam direção humana atenta.
Eu diria que esse caso vale menos como disputa de modelos e mais como retrato de processo. O que fica não é só “o game ficou pronto”. O que fica é o mapa: ideia herdada, nova leitura, geração, revisão falha, intervenção humana, correção e documentação completa.
Como isso conversa com AI-Building
Se eu tivesse de resumir a ligação com AI-Building, eu diria o seguinte: criar com IA não é terceirizar pensamento. É coordenar pensamento distribuído. Esse experimento mostra isso de forma muito concreta.
Houve uma intenção inicial. Houve agentes trabalhando em partes diferentes. Houve revisão. Houve falha. Houve nova instrução. Houve correção. Esse ciclo é exatamente o tipo de prática que a Replitfy procura ensinar quando fala em co-criar com IA e implantar sistemas de ponta a ponta em menos tempo.
Quem gosta de rotinas mais práticas também pode acompanhar a categoria de dicas, porque ela ajuda a transformar casos isolados em hábito de trabalho.
Informativo mensal e posts recentes
Também vale registrar que existe um informativo mensal que pode ser enviado por e-mail mediante assinatura de US$10, reunindo as novidades mais relevantes sobre LLM do mês. Eu acho esse tipo de curadoria útil para quem quer acompanhar mudanças sem depender apenas de fragmentos soltos ao longo da semana.
No fechamento, estes são os três posts recentes do blog citados neste contexto:
O ataque acidental da OpenAI contra a Hugging Face em 7 de agosto de 2026.
O teste do Raccoon Heist com Claude Fable 5 em 5 de agosto de 2026.
O anúncio de um novo LLM com recursos como reasoning traces, respostas OpenAI, ferramentas server-side e log mais inteligente no dia 4 de agosto de 2026.
Conclusão
Depois de acompanhar esse experimento, eu fiquei com uma impressão bem clara. O GPT-5.6 Sol Ultra, rodando no Codex Desktop com uso intenso de subagentes, não apenas fez um jogo. Ele mostrou um jeito de construir. O museu, os três guaxinins, a sardinha dourada e até o erro grotesco do olho flutuante compõem um retrato honesto do estado atual dessa forma de desenvolvimento.
Quando a IA acerta, ela encurta o caminho. Quando falha, ela revela onde o olhar humano ainda faz diferença.
Para mim, esse é o ponto mais valioso. Não se trata só de gerar um game curioso. Trata-se de aprender como orientar, revisar e corrigir sistemas criados em parceria com modelos de linguagem. Se você quer entender esse processo de forma aplicada e dar os próximos passos em AI-Building com apoio técnico e método, vale conhecer melhor a Replitfy e ver como os cursos e mentorias podem ajudar nessa nova fase do desenvolvimento.
Perguntas frequentes
O que é o GPT-5.6 Sol Ultra?
Eu entendo o GPT-5.6 Sol Ultra, neste contexto, como o modelo usado dentro do Codex Desktop para criar o game do experimento. Ele conta com um modo de trabalho com uso intenso de subagentes, o que permite dividir tarefas de criação, revisão e ajuste ao longo do processo. Neste caso, ele foi o núcleo que transformou a proposta do roubo dos guaxinins em um jogo de museu jogável.
Como o game usa subagentes?
Pelo que vi no experimento, os subagentes ajudam a separar funções durante a construção do projeto. Parte do sistema cuida da lógica, parte revisa imagens, parte acompanha a estrutura do jogo e parte ajuda nos ajustes. Isso não impede erros, como o caso dos olhos gigantes, mas acelera a montagem e a revisão do conjunto. Eu vejo os subagentes como uma forma de distribuir o trabalho criativo e técnico.
Como posso jogar esse game único?
O texto do experimento informa que o repositório inclui toda a transcrição do Codex, o que ajuda a estudar como o game foi feito. Para jogar, o caminho depende da publicação do build ou da execução a partir do repositório correspondente. O ponto mais útil aqui é que o projeto foi documentado de modo que outras pessoas possam reproduzir, revisar ou adaptar a experiência.
Quais as principais vantagens desse game?
Eu destacaria quatro vantagens. Primeiro, o conceito é claro e fácil de entender. Segundo, a mecânica de resgatar e empilhar os guaxinins conversa com a narrativa do roubo. Terceiro, o cenário de museu reforça o tema sem exigir explicação longa. Quarto, o experimento mostra um fluxo real de criação com IA, incluindo correção após revisão. Isso faz do game não só um produto curioso, mas também um caso de estudo.
Vale a pena usar subagentes em jogos?
Na minha visão, vale sim, especialmente em protótipos e ciclos rápidos de criação. Os subagentes ajudam a montar partes diferentes do projeto ao mesmo tempo e podem acelerar testes e correções. Ainda assim, eu não deixaria tudo por conta deles. Subagentes funcionam melhor quando há direção humana clara, revisão objetiva e critério para validar o resultado final.